Ein mittelständisches Unternehmens betreibt sein ERP, Microsoft Dynamics 365 Business Central, auf eigenem SQL Server. Die Daten liegen dort, wo die eigene IT sie kontrollieren kann.
Für sein Unternehmen rechnet die Führungsmannschaft damit, dass die nächste Ausbaustufe in der Cloud läuft. Gleichzeitig stehen Business Intelligence und KI auf der Agenda. Spätestens hier stellt sich die Frage, die in diesem Gespräch und in vielen ähnlichen Gesprächen der letzten Monate aufkam: Wie werden die eigenen Daten für BI und KI nutzbar, ohne die Kontrolle über sie aufzugeben?
Die Beobachtung
Die Gespräche folgen einem wiederkehrenden Muster. Die Unternehmen kommen aus einer Welt, in der möglichst alles im eigenen Hosting liegt. Daten werden gehütet wie der Augapfel. BI und KI sollen trotzdem kommen.
Strukturierte Daten sind dabei das kleinere Problem. ERP, CRM und Marketing-Datenquellen liefern Tabellen, deren Anbindung an eine Datenplattform erprobt ist. Die Unsicherheit beginnt bei den unstrukturierten Daten: Dokumente in SharePoint und OneDrive wie Angebote, Verträge, Protokolle und Spezifikationen. Und E-Mails mit Anfragen, Reklamationen und Absprachen. Dort liegt ein großer Teil des Unternehmenswissens, und dort wird Datenschutz am schnellsten zum Problem.
Die Anforderungen der Geschäftsführer sind bemerkenswert einheitlich. Der Zugriff soll sicher sein, ohne Datenabfluss in andere Regionen der Welt, mit ausdrücklichem Human-in-the-Loop, ohne Bindung an ein einzelnes Sprachmodell und gemeinsam mit den strukturierten Daten. Ziel sind keine Großprojekte. Ziel sind kleinere Agenten und überschaubare Automatisierungen.
Die Einordnung: Microsoft hat die Bausteine, aber keine verständliche Antwort
Microsoft liefert für fast jeden Schritt dieser Kette ein Produkt. Seit der Build 2026 bündelt Microsoft das unter dem Begriff „Microsoft IQ“: Work IQ für Microsoft 365, Fabric IQ für Daten und Semantik, Foundry IQ für Wissen und Retrieval für Agenten. Dazu kommen OneLake-Shortcuts, Fabric AI Functions, Azure AI Search, Content Understanding, Graph Data Connect und der Fabric Data Agent.
Was fehlt, ist die verständliche Antwort, wie diese Teile zusammen eine Architektur ergeben. Selbst wer täglich im Microsoft-Ökosystem arbeitet, muss sie sich aus Produktdokumentation, Preview-Ankündigungen und Lizenzbedingungen zusammensetzen. Für einen Geschäftsführer eines Unternehmens mit einigen hundert Mitarbeitern ist das nicht leistbar. Microsoft hat hier deutlichen Aufholbedarf in der Kommunikation.
Der Reifegrad ist zudem uneinheitlich. Dokumente aus SharePoint und OneDrive sind heute produktionsreif abgedeckt: Der OneLake-Shortcut auf Dokumentbibliotheken ist allgemein verfügbar. Für klassische Fileserver gibt es keinen OneLake-Shortcut. Bei E-Mails bleibt die Kette lückenhaft: kein Shortcut, kein Mirroring, On-Premises-Postfächer sind ausgeschlossen.
Die These
Mindestens jeder zweite Mittelstandsgeschäftsführer stellt heute genau diese Frage, unabhängig vom Hersteller. Für Microsoft-Kunden ist sie besonders drängend, weil ein Großteil ihrer unstrukturierten Daten bereits in Exchange, SharePoint und OneDrive liegt.
Die Antwort existiert. Sie ist eine Architektur aus zwei Plattformen mit klarer Arbeitsteilung, auf einen Satz gebracht:
Fabric + Foundry = BI und KI auf einer sinnvollen Datenarchitektur.
Die Architektur, die tractionwise heute empfiehlt: Microsoft Fabric + Foundry
Fabric ist die Datenplattform: Anbindung, Speicherung, Aufbereitung, Modellierung, Analyse. Foundry ist die KI- und Anwendungsplattform: Suchindex, Dokumentverständnis, Modellbetrieb, Agenten. Die Brücke ist OneLake. Mit reinem Fabric-Fokus ist etwa die Hälfte der Kette abgedeckt. Sobald Fragen an Verträge und Kennzahlen zugleich gestellt werden, kommen Azure AI Search, ein Foundry-Projekt, Netzwerk und Entra-Berechtigungen dazu. Diese Brücke sauber zu bauen ist das eigentliche Architekturthema.
Business Central wird per Connector geladen, SharePoint und OneDrive per OneLake-Shortcut ohne Kopie sichtbar gemacht. In OneLake ziehen Fabric AI Functions aus PDFs Felder wie Vertragsende oder Zahlungsbedingungen in Tabellen. Auf den Gold-Tabellen setzen Semantic Model und Power BI auf, der Fabric Data Agent beantwortet Fragen in natürlicher Sprache. Parallel indiziert Foundry IQ die aufbereiteten Dokumente. Foundry-Agenten nutzen diesen Index und greifen bei Bedarf auf die Kennzahlen zu. Die Antwort entsteht aus Dokument und Zahl zugleich. Der Weg der E-Mails in der Grafik ist technisch möglich, folgt aber einer eigenen Entscheidung (siehe unten).
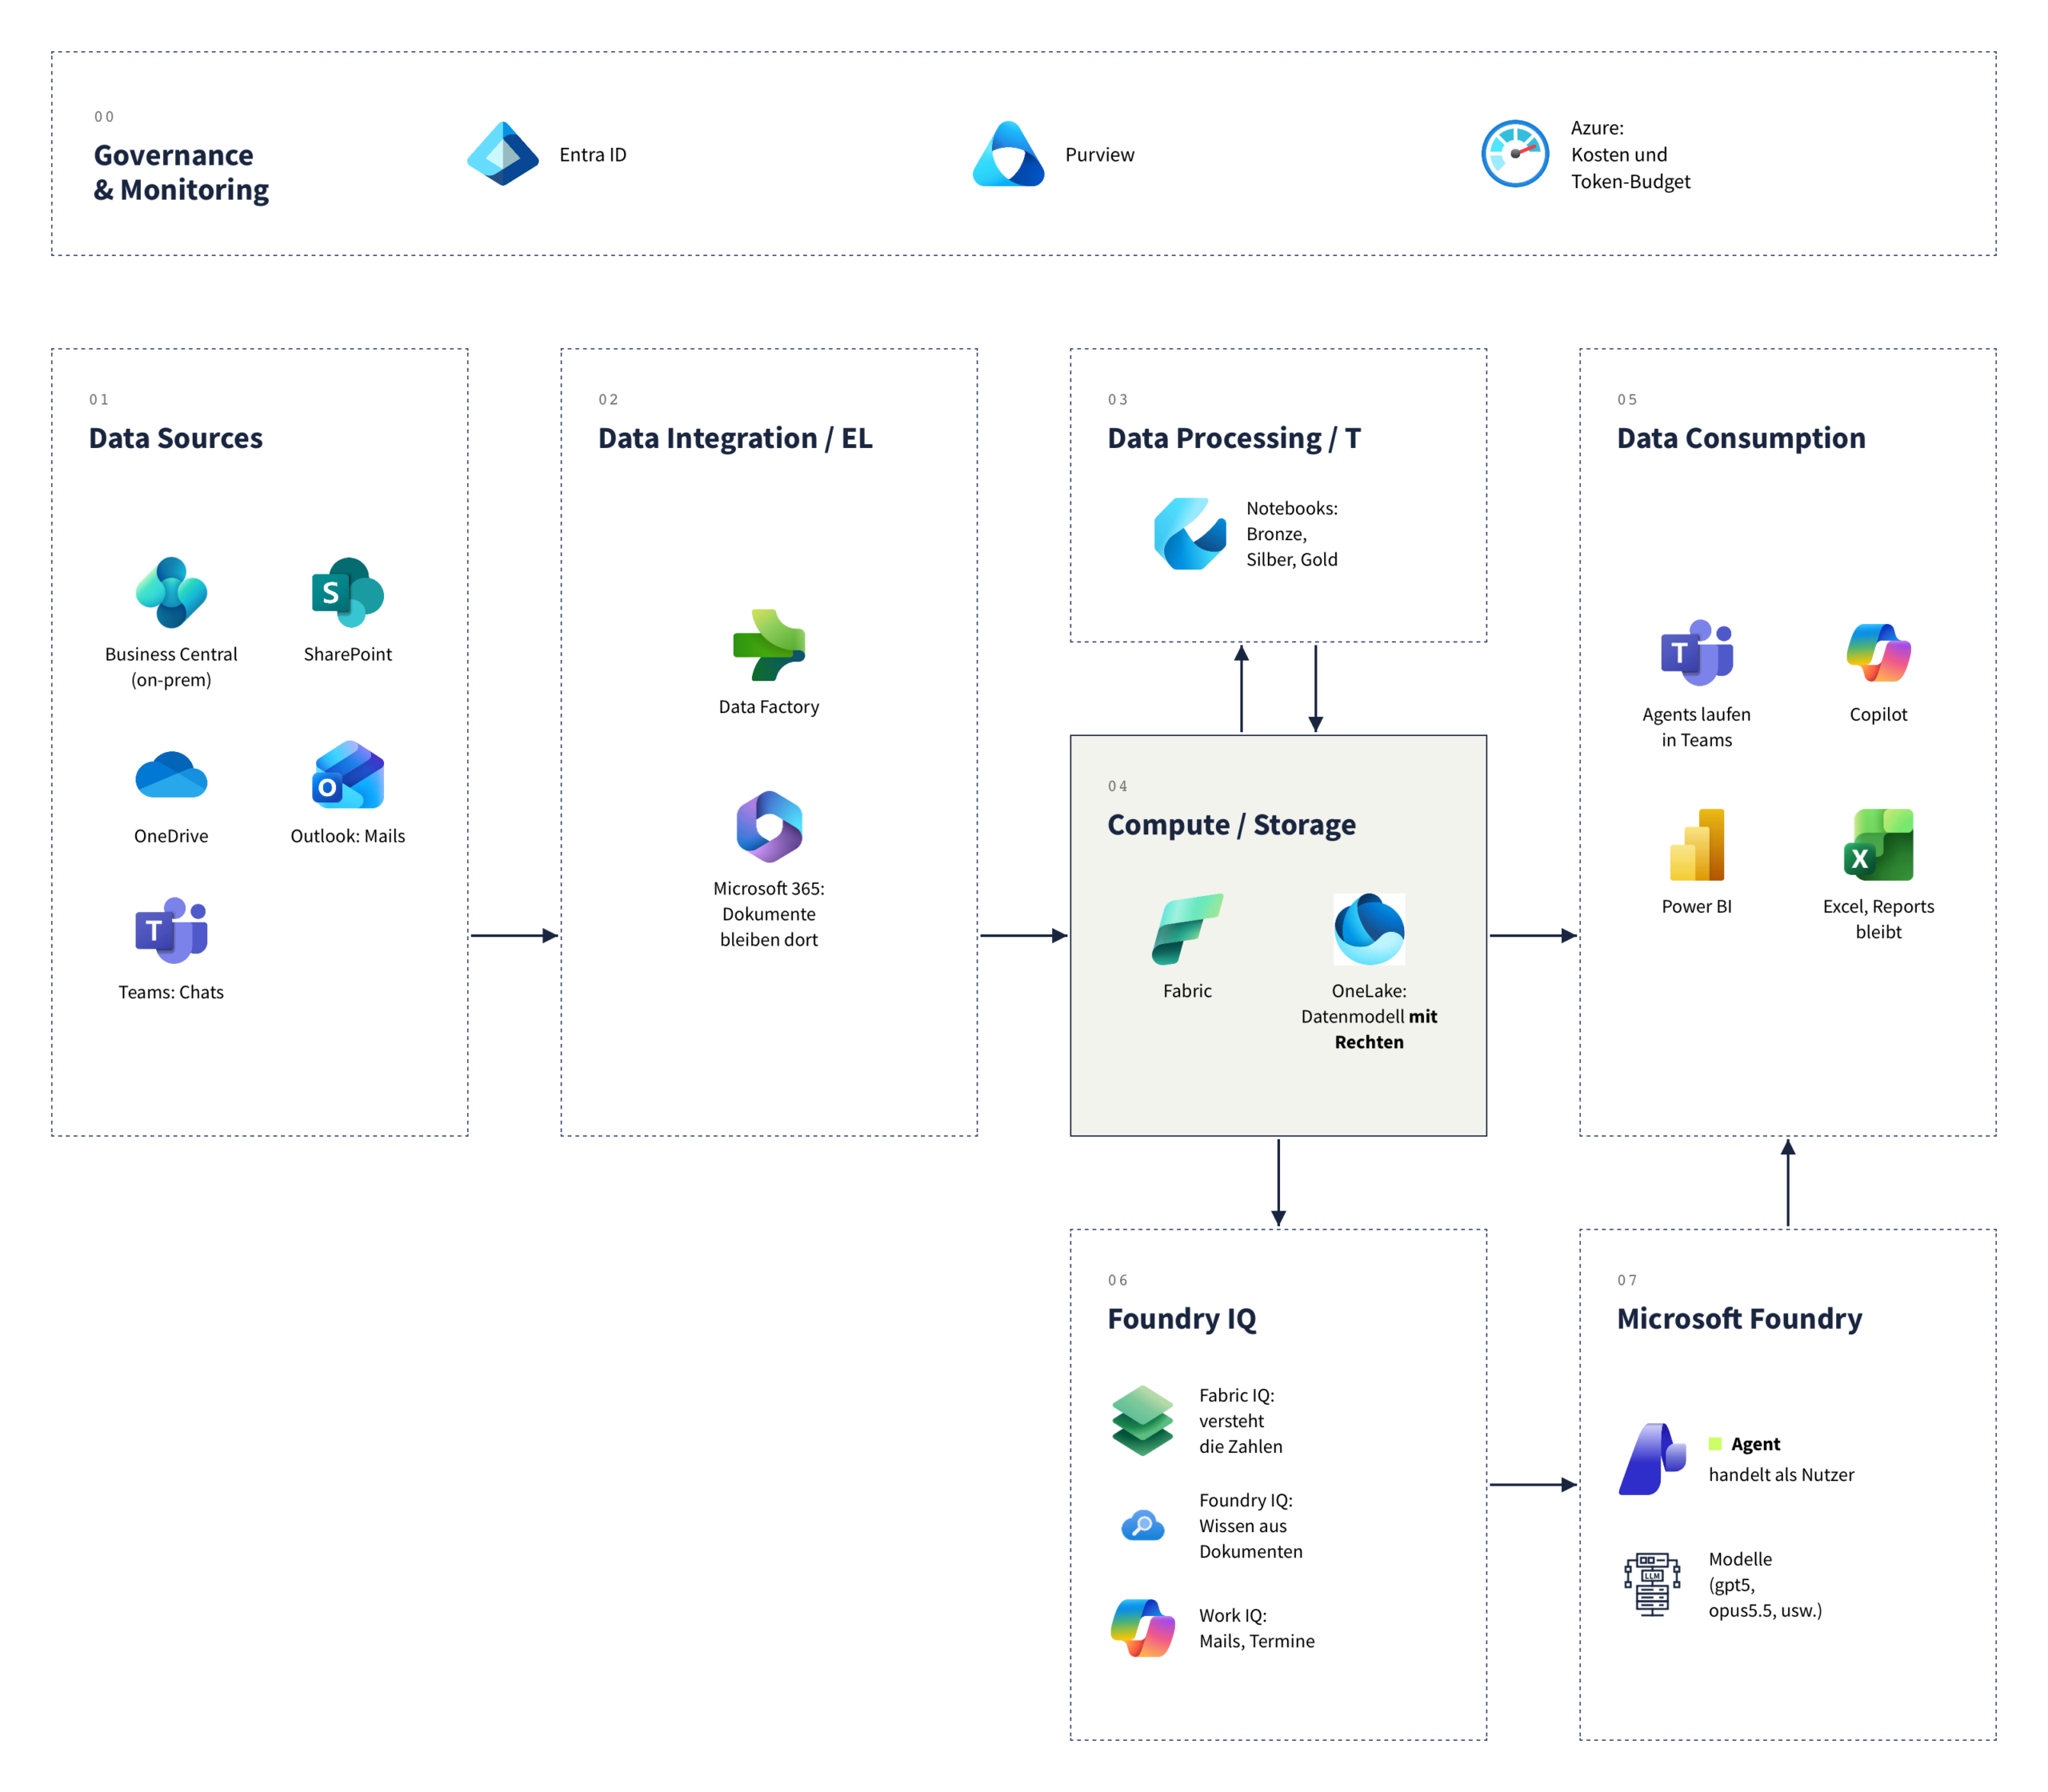
Architekturschema

30 Minuten, nach denen Sie klarer sehen.
Das Vorgehen: fünf Entscheidungen in fester Reihenfolge
Die Architektur ist der Rahmen. Individuell ist die Ausprägung, und die folgt einer festen Reihenfolge.
1. Berechtigungen vor dem Bau klären
Das ist der kritischste Punkt. Shortcuts mit Service Principal vergröbern SharePoint-Rechte auf OneLake-Rollen. Der Suchindex ist eine zweite Kopie mit eigener Berechtigungsschicht, die automatische Übernahme von SharePoint-Berechtigungen ist noch Preview. Sensible Bibliotheken werden von Anfang an getrennt.
2. Mit Dokumenten beginnen
SharePoint und OneDrive sind heute produktionsreif. Ein erster Anwendungsfall mit Dokumenten liefert schnell belastbare Ergebnisse.
3. Altbestände an laufende Migrationen koppeln
Fileserver werden nach SharePoint migriert oder über eine S3-kompatible NAS-Schnittstelle angebunden. SQL Server 2025 lässt sich per Mirroring nach Fabric spiegeln, mit Azure Arc als Voraussetzung.
4. Human-in-the-Loop und Modellunabhängigkeit über die Datenhaltung absichern
Agenten schlagen vor, Menschen entscheiden. Die aufbereiteten Daten liegen als Delta-Tabellen in OneLake, unabhängig vom Modell, das sie nutzt. Das Modell wird über den Foundry-Modellkatalog gewählt und bleibt austauschbar. Einschränkung: Die KI-Funktionen innerhalb von Fabric nutzen Modelle aus Azure. Wer maximale Unabhängigkeit will, hält die Extraktionslogik schlank und dokumentiert sie.
5. Kosten über beide Abrechnungsmodelle planen
AI Functions verbrauchen Fabric-Capacity. Suchindex und Token-Verbrauch in Azure laufen außerhalb davon und werden getrennt budgetiert. Remote SharePoint und Work IQ setzen Copilot-Lizenzen pro Nutzer voraus.
E-Mails: ein eigenes Thema
E-Mails gehören in eine eigene Entscheidung. Technisch ließen sie sich exportieren, chunken und vektorisieren wie jedes andere Dokument. Genau das sollte nicht der Reflex sein.
Ein Postfach ist kein Dokumentenarchiv. Es enthält personenbezogene Daten von Beschäftigten, Kunden und Dritten, private Inhalte, Gesundheitsangaben in Krankmeldungen, Gesprächsverläufe mit Leistungs- und Verhaltensbezug. Ein Suchindex über diese Inhalte schafft eine zweite, durchsuchbare Kopie mit eigener Berechtigungslogik. Die Frage, wer darin was finden darf, ist bei Dokumenten aufwendig und bei E-Mails um ein Vielfaches schwieriger.
Dazu kommt das Arbeitsrecht. Systeme, die geeignet sind, Verhalten oder Leistung von Beschäftigten zu überwachen, sind nach § 87 Abs. 1 Nr. 6 BetrVG mitbestimmungspflichtig. Eine KI-Auswertung von Postfächern fällt in der Regel darunter. In Unternehmen mit Betriebsrat kann das einen Anwendungsfall verzögern oder ganz verhindern. Technisch lösen lässt sich das nicht.
Die Empfehlung lautet deshalb: Zweck zuerst, Technik danach.
- Nutzerassistenz für Fragen einzelner Mitarbeiter an ihre eigenen Mails läuft über Work IQ beziehungsweise Copilot, im Berechtigungskontext des Nutzers und ohne Kopie im Lakehouse.
- Prozessautomatisierung auf Funktionspostfächern wie Service oder Einkauf ist der naheliegende Einstieg, weil Zweck und Inhalt klar umrissen sind.
- Aggregierte Analysen über Postfächer hinweg laufen über Graph Data Connect, nur mit Zweckbindung, Pseudonymisierung, Datenschutz-Folgenabschätzung und Einbindung des Betriebsrats.
On-Premises-Exchange ist für diese Wege praktisch ausgeschlossen und wird an die Migration nach Exchange Online gekoppelt.
Und die Alternativen?
Die Frage ist herstellerunabhängig, die Antwort nicht. AWS bietet mit Bedrock Managed Knowledge Bases, auch in Frankfurt, Connectoren für SharePoint und OneDrive, Amazon Q Business einen eigenen Exchange-Connector inklusive Berechtigungen. Google Cloud bringt Dateien über BigQuery ObjectRef direkt ins Warehouse, Gemini Enterprise bietet Connectoren für SharePoint, OneDrive, Outlook und Teams. Beide sind bei der M365-Anbindung teils breiter aufgestellt als Microsoft selbst. Bei Souveränität stehen sie auf derselben Stufe: EU-Regionen, US-Anbieter.
STACKIT punktet als deutscher Anbieter bei Souveränität. Mit AI Model Serving, pgvector und einem Open-Source-RAG-Template liefert es Bausteine, aber keine nativen M365-Connectoren. Ein Team, das RAG-Pipelines selbst betreibt, findet dort eine ernsthafte Option.
Für einen Mittelständler mit Microsoft 365 und Fabric bleibt die Kombination aus SharePoint-Shortcut, AI Functions, Foundry IQ und Data Agent heute der kürzeste Weg zu Dokumenten und Kennzahlen in einer Antwort. Die Daten liegen bereits dort, der Integrationsaufwand ist am geringsten.
Microsoft sollte diese Antwort selbst klar kommunizieren. Bis das geschieht, liegt sie bei denen, die die Architektur bauen.